RAG (Retrieval-Augmented Generation) to wzorzec, w którym aplikacja przed zapytaniem modelu wyszukuje w danych fragmenty związane z pytaniem i dołącza je do promptu. Model odpowiada wtedy na podstawie dostarczonego tekstu, a nie tylko tego, co zapamiętał podczas treningu. RAG pozwala modelowi korzystać z prywatnych dokumentów, regulaminów, wiki zespołu albo bazy wiedzy firmy bez trenowania własnego modelu.
Model nie zna dokumentów, których nie widział, i nie zawsze się do tego przyznaje. Zapytany o szczegół, którego nie zna, potrafi odpowiedzieć pewnie, ale nieprawdziwie (halucynacje). Wklejenie całej dokumentacji do każdego promptu nie rozwiązuje problemu, bo kosztuje tokeny przy każdym wywołaniu i zapycha okno kontekstu. RAG wybiera tylko te fragmenty, które prawdopodobnie mają szansę odpowiedzieć na konkretne pytanie.
Nowicjusz z poprzedniego wpisu miał grymuar z kilkoma zaklęciami (MCP server). Teraz dostał dostęp do wieży z biblioteką, w której są księgi o zaklęciach, ziołach i historii wieży. Wszystkiego nie zapamięta, a bez bazy wiedzy, zapytanie kończy się przeprosinami modelu albo halucynacjami. Przed odpowiedzią ma więc sprawdzić księgi i podać, z której pochodzi odpowiedź.
Spis treści
Pokaż spis treści
Jak działa RAG
Indeksowanie
Pierwszy etap odbywa się raz, przed jakimkolwiek promptem od użytkownika. Dokumenty dzieli się na fragmenty (chunks), bo w całości są za duże i zbyt ogólne, żeby trafnie odpowiadać na konkretne pytania. W demo jeden fragment to jedna sekcja księgi, na przykład opis zaklęcia Fireball.
Każdy fragment trafia do modelu embedding, który zamienia tekst na wektor. Teksty o podobnym znaczeniu dają wektory leżące blisko siebie, nawet gdy nie mają żadnego wspólnego słowa. Dzieje się tak, ponieważ proces uczenia modelu embedding oparty jest na tak zwanej hipotezie dystrybucyjnej. Mówi ona mniej więcej, że “słowa, które występują w podobnych kontekstach mają podobne znaczenie”, więc ich wektory leżą blisko siebie w wielowymiarowej przestrzeni. Wektory mają kilkaset, a nawet kilka tysięcy wymiarów, a reprezentowane są jako jednowymiarowa tablica liczb. Wektory razem z oryginalnym tekstem trafiają do bazy wektorowej, która potrafi szybko znaleźć najbliższe sąsiedztwo zadanego wektora.
Wyszukiwanie
Prompt od user’a przechodzi przez ten sam model embeddingów i jest zamieniany na wektor. Następnie baza zwraca fragmenty o najbliższych wektorach w stosunku do prompt’a, razem z miarą podobieństwa (score). Liczba zwracanych fragmentów to parametr top-k. Wyszukiwanie nie rozumie pytania, tylko porównuje odległości.
Odpowiedź z fragmentami w kontekście
Znalezione fragmenty trafiają do modelu językowego razem z pytaniem. Można to zrobić na dwa sposoby. Pierwszy to dołączanie fragmentów do każdego promptu z góry, bez pytania modelu o zdanie. Drugi to udostępnienie wyszukiwania jako narzędzia, tak samo jak zaklęcia z grymuaru. Model sam decyduje, czy i czego szukać, a odpowiedź składa po wyniku narzędzia.
Demo używa drugiego wariantu. Dla pytania o Fireball Claude odpowiada blokiem tool_use, podobnym do tych z poprzednich wpisów:
{
  "type": "tool_use",
  "id": "toolu_01...",
  "name": "search_library",
  "input": { "query": "fireball heartbeats hold throw casting" }
}
Aplikacja wykonuje wyszukiwanie, odsyła fragmenty w bloku tool_result i dopiero po nim model pisze odpowiedź. Model może przy tym przeformułować pytanie na lepsze query i wywołać narzędzie kilka razy.
Skąd wziąć embeddingi
Claude nie generuje embeddingów, bo Anthropic nie oferuje takiego modelu, dlatego wektory pochodzą z innego źródła. W demo jest to lokalny model nomic-embed-text uruchomiony w Ollama, dzięki czemu nie potrzeba drugiego klucza API, a indeksowanie działa lokalnie, bez internetu i bez opłat.
Czego potrzeba
- klucz API Anthropic, zapisany w user secrets tak samo jak w poprzednich wpisach,
- Docker, który uruchomi bazę Qdrant i Ollamę,
Założenie projektu
Repozytorium ma jeden projekt webowy, ten sam szablon co w pozostałych wpisach, bo DevUI i endpointy OpenAI Responses potrzebują ASP.NET Core:
dotnet new sln --format slnx -n LibraryRagDemo
dotnet new web -n NoviceMage --framework net10.0
dotnet sln add NoviceMage
Baza i model embedding działają w kontenerach. Plik compose.yaml uruchamia oba:
services:
  qdrant:
    image: qdrant/qdrant:v1.15.0
    ports:
      - "6333:6333" # REST
      - "6334:6334" # gRPC
  ollama:
    image: ollama/ollama:latest
    ports:
      - "11434:11434"
W pełnej wersji plik zawiera też wolumeny na dane, żeby kolekcja i pobrany model przetrwały restart. Po docker compose up -d trzeba jeszcze pobrać model embedding do kontenera:
docker compose exec ollama ollama pull nomic-embed-textPort 6334 to gRPC, z którego korzysta klient .NET. Port 6333 to REST, przydatny do podglądu kolekcji w przeglądarce i z curl.
Instalacja paczek
cd NoviceMage
dotnet add package Anthropic --version 12.50.0
dotnet add package Microsoft.Agents.AI.Hosting --version 1.22.0-preview.260918.1
dotnet add package Microsoft.Agents.AI.Hosting.OpenAI --version 1.22.0-alpha.260918.1
dotnet add package Microsoft.Agents.AI.DevUI --version 1.22.0-preview.260918.1
dotnet add package OllamaSharp --version 5.5.0
dotnet add package Qdrant.Client --version 1.19.0
Pierwsze cztery paczki składają agenta tak samo jak wcześniej: klient Claude, hosting agentów, endpointy OpenAI Responses i DevUI. OllamaSharp to klient Ollamy, który implementuje IEmbeddingGenerator z Microsoft.Extensions.AI. Qdrant.Client to oficjalny klient bazy, komunikujący się przez gRPC.
Biblioteka i indeksowanie
Księgi i fragmenty
Biblioteka to trzy krótkie księgi w katalogu Library: o ogniu, o ziołach i o wpadkach uczniów wieży. Oczywiście są wymyślone, a model nie może ich znać z treningu. Odpowiedź na pytanie o te księgi da się sprawdzić z tekstem w ręku. Ten fragment pochodzi z tome-of-embers.md:
## Fireball

A fireball needs a clear target and a steady hand. The caster must hold the
flame for exactly three heartbeats before throwing it. Novices who throw after
two heartbeats burn their own sleeves. Novices who wait for four heartbeats
burn their fingers.
Dzielenie na fragmenty robi metoda Chunk. Jeden fragment to jedna sekcja ##, poprzedzona tytułem księgi:
foreach (var section in text.Split("\n## ", StringSplitOptions.RemoveEmptyEntries).Skip(1))
{
    yield return (source, $"{title}\n## {section.Trim()}");
}
Tytuł dołączony do każdego chunk’a służy do identyfikacji źródła, z którego pochodzi dany fragment. Podział po sekcjach działa tutaj dlatego, że księgi mają czytelną strukturę. Dla dokumentów bez takiej struktury zwykle stosuje się okna o stałej długości z częściową zakładką. Przykładowo pierwszy chunk może mieć 120 znaków od indeksu 0 do 119, drugi chunk również 120 znaków, ale od indeksu 100 do 219. Widać tu, że znaki na indeksach 100 do 119 są powielone w chunku pierwszym (na końcu chunka) i drugim (na początku chunka). Wtedy wektory następujących po sobie chunków są bliżej siebie, bo dzielą ze sobą fragment tekstu. Odpowiedź na prompt od użytkownika może znajdować się w wielu kolejnych chunkach, a dzielenie ich z zakładką daje większą szansę, że odpowiednie wektory zostaną zwrócone w odpowiedzi z bazy.
Zapis do Qdrant
Klasa Library przyjmuje klienta Qdrant i generator embeddingów. Indeksowanie najpierw usuwa starą kolekcję, żeby uruchomienie aplikacji dało zawsze ten sam stan, a potem liczy wektory dla wszystkich fragmentów jednym wywołaniem:
var vectors = await embeddings.GenerateAsync(chunks.Select(c => c.Text));

await qdrant.CreateCollectionAsync(Collection, new VectorParams
{
    Size = (ulong)vectors[0].Vector.Length,
    Distance = Distance.Cosine,
});
Rozmiar wektora pochodzi z samego wyniku, a nie z liczby wpisanej w kodzie. Dla nomic-embed-text jest to 768 wymiarów. Cosine distance porównuje kierunek wektorów, a nie ich długość, i jest standardowym wyborem dla embeddingów tekstu.
Każdy fragment trafia do kolekcji jako punkt z wektorem i dodatkowymi danymi (payload):
var points = chunks.Select((chunk, i) => new PointStruct
{
    Id = (ulong)i,
    Vectors = vectors[i].Vector.ToArray(),
    Payload =
    {
        ["source"] = chunk.Source,
        ["text"] = chunk.Text,
    },
}).ToList();

await qdrant.UpsertAsync(Collection, points);
Pole text pozwala od razu po wyszukaniu oddać modelowi treść fragmentu, bez drugiego zapytania do osobnego magazynu. Pole source służy do wskazania źródła w odpowiedzi. Siedem sekcji z trzech ksiąg daje siedem punktów w kolekcji.
Wyszukiwanie
Wyszukiwanie to ten sam model embeddingów dla pytania i zapytanie o najbliższe punkty:
var vector = await embeddings.GenerateVectorAsync(query);
var hits = await qdrant.QueryAsync(Collection, vector.ToArray(), limit: (ulong)limit);
Metoda zwraca trafienia z polami Score i Payload.
Agent z narzędziem search_library
Agent korzysta z tego samego IChatClient z Claude co w poprzednich wpisach, a obok niego w DevUI jest drugi, zwykły NoviceMage, bez dostępu do biblioteki. Dzięki temu to samo pytanie można zadać obu i porównać odpowiedzi. Wyszukiwanie to funkcja z opisem, którą Agent Framework zamienia na narzędzie:
[Description("Searches the tower library and returns the most relevant passages with their source tome.")]
async Task<string> SearchLibrary(
    [Description("What to look for, as a short natural language query.")] string query)
{
    var hits = await library.SearchAsync(query);
    return string.Join("\n\n", hits.Select(h => $"[{h.Source}, score {h.Score:F2}]\n{h.Text}"));
}
Opisy w atrybutach Description trafiają do definicji narzędzia wysyłanej do Claude i to na ich podstawie model decyduje, kiedy z niego skorzystać. Wynik zawiera nazwę księgi i wartość score, więc model ma z czego zacytować źródło.
Zachowaniem agenta steruje prompt systemowy. Do nowicjusza z dostępem do biblioteki dochodzi fragment:
You have access to the tower library. Before answering any question about
spells, herbs or the history of the tower, call search_library and answer
only from what it returns. Say which tome the answer comes from. If the
library has nothing about the question, say that you could not find it.
Agent powstaje przez AsAIAgent na kliencie czatu, z narzędziem AIFunctionFactory.Create(SearchLibrary, "search_library"). Reszta Program.cs jest taka sama jak w poprzednich wpisach: endpointy Responses i Conversations oraz DevUI w środowisku Development. Biblioteka jest indeksowana przy starcie aplikacji, przed app.Run().
Uruchomienie i demo
Przy starcie aplikacja indeksuje księgi, więc Qdrant i Ollama muszą już działać. Projekt uruchamia się pod adresem http://localhost:5018.
Bez biblioteki
Pierwsze pytanie dotyczy szczegółu, który istnieje tylko w księgach, i trafia do zwykłego agenta:
curl -s http://localhost:5018/v1/responses \
  -H "Content-Type: application/json" \
  -d '{"model":"NoviceMage","agent":{"name":"NoviceMage","type":"agent_reference"},"input":"How many heartbeats must a caster hold a fireball before throwing it, and what happens if a novice waits too long?"}'
Odpowiedź (po skróceniu do tekstu odpowiedzi):
Well, from what Master has taught me, you usually hold a fireball for about
three to five heartbeats before you throw it. [...] If a novice like me holds
it too long, the magic gets too hot to control. The fireball can:
- Burn your hands really badly
- Explode right there in your palms
- Go wild and hit the wrong target
Odpowiedź brzmi pewnie i jest błędna. Księga mówi o dokładnie trzech uderzeniach serca, a nie o przedziale od trzech do pięciu, a skutki zwłoki są inne. Zużycie to 328 tokenów, z czego 86 na wejściu.
Z biblioteką
To samo pytanie trafia do NoviceMageLibrarian.
curl -s http://localhost:5018/v1/responses `
  -H "Content-Type: application/json" `
  -d '{"model":"NoviceMageLibrarian","agent":{"name":"NoviceMageLibrarian","type":"agent_reference"},"input":"How many heartbeats must a caster hold a fireball before throwing it, and what happens if a novice waits too long?"}'
Claude wywołał search_library dwa razy, z zapytaniami fireball heartbeats hold throw casting i novice fireball too long wait danger. Odpowiedź po wynikach narzędzia (skrócona):
Oh! I found the answer in the Tome of Embers!
You need to hold a fireball for exactly three heartbeats before you throw it.
If a novice waits too long - like four heartbeats - they will burn their own
fingers. And if you throw it too early after just two heartbeats, you'll burn
your own sleeves instead.
Tym razem odpowiedź zgadza się z księgą i wskazuje źródło. Cena to 2716 tokenów, z czego 2467 na wejściu, czyli ponad ośmiokrotnie więcej niż bez biblioteki. Fragmenty z wyszukiwania i definicja narzędzia wchodzą do każdego wywołania modelu, a z tych tokenów składa się większość rachunku.
DevUI pokazuje ten sam przebieg. Zrzut poniżej przedstawia czystą rozmowę z NoviceMageLibrarian:
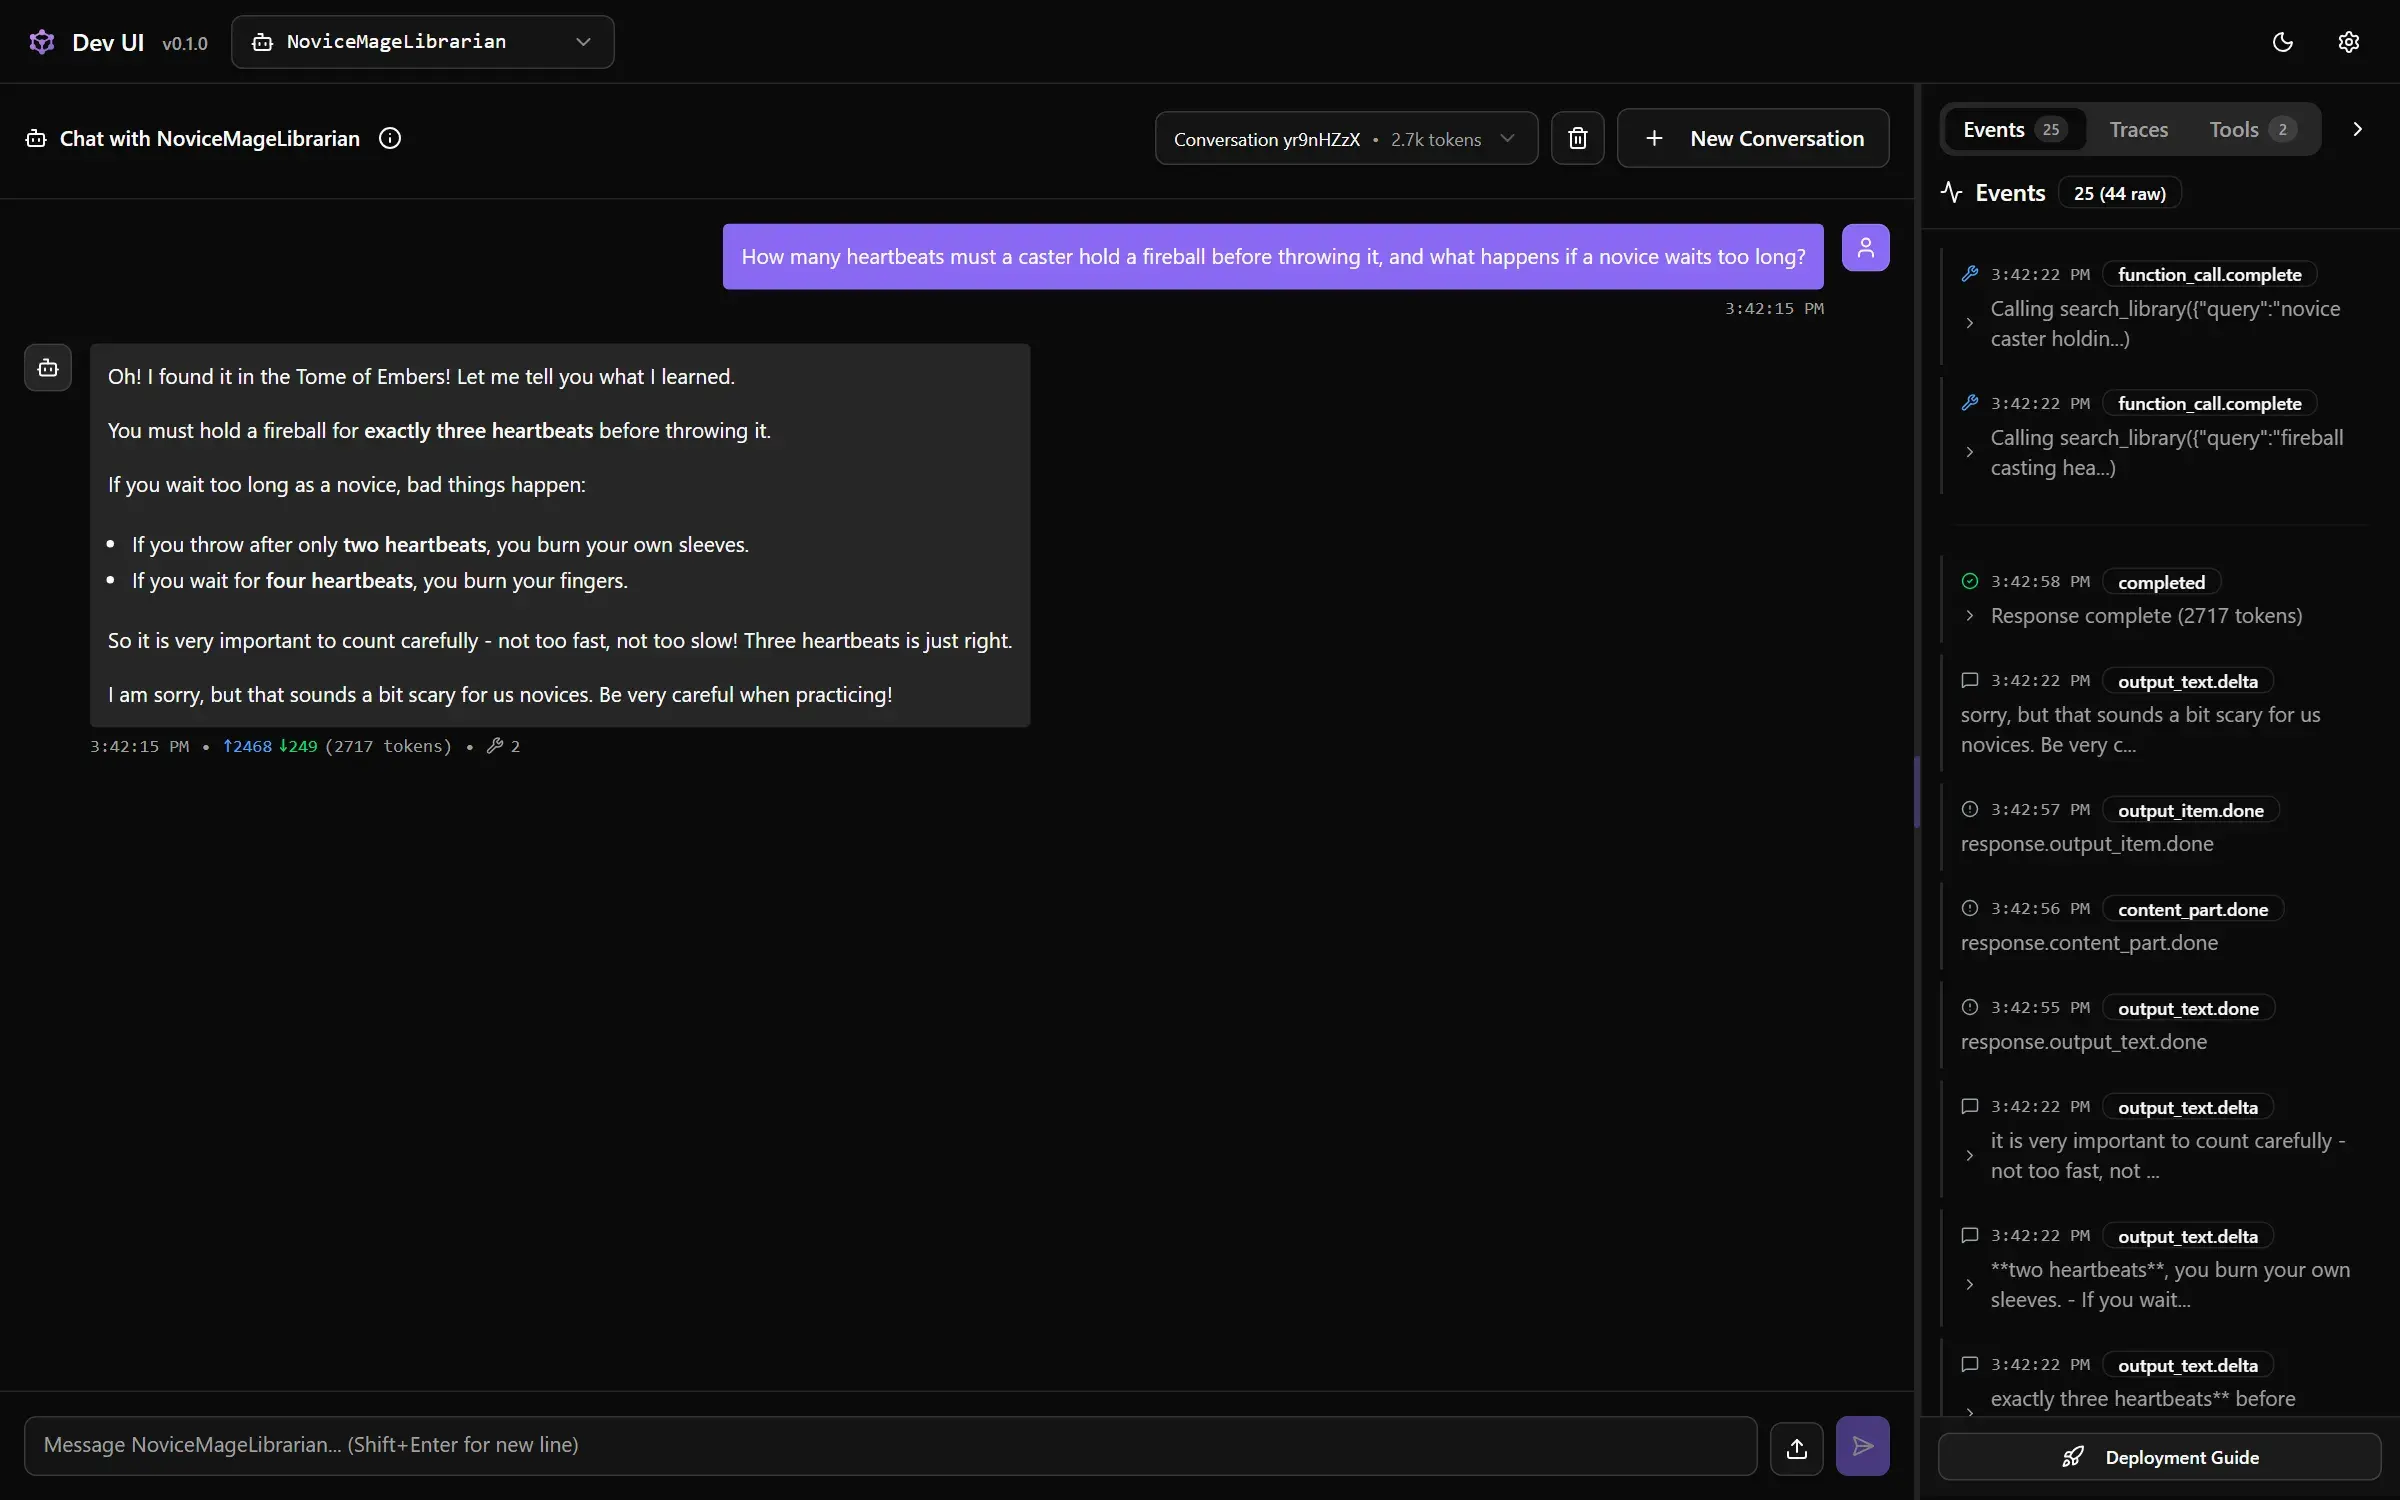
Po lewej widać pytanie i odpowiedź z cytatem z Tome of Embers, a pod odpowiedzią licznik 2717 tokenów i ikonę narzędzia z liczbą 2. W panelu Events po prawej są dwa zdarzenia function_call.complete z zapytaniami przekazanymi do search_library, a pod nimi strumień zdarzeń output_text.delta z odpowiedzią.
Ograniczenia
Wyszukiwanie zawsze coś zwraca
Baza wektorowa zwraca najbliższe punkty, a nie punkty, które pasują. Pytanie o zamianę ołowiu w złoto, o czym nie ma ani słowa w księgach, dało poniższe wyniki (wartości z bezpośredniego zapytania do Qdrant, skrócone):
How long to hold a fireball?
  0.75  tome-of-embers  ## Fireball
  0.54  tome-of-embers  ## Frost Nova
  0.52  tome-of-herbs   ## Dragon's Thimble

What is the spell for turning lead into gold?
  0.61  tome-of-herbs   ## Dragon's Thimble
  0.57  tome-of-mishaps ## Rule of the Singed Eyebrows
  0.57  tome-of-herbs   ## Moonpetal
Kilka chunków zostanie zwrócone, także gdy żaden nie ma związku z pytaniem. W demo agent odpowiedział, że niczego nie znalazł, ale zrobił to LLM, który ocenił fragmenty jako nietrafione, a nie filtr w zapytaniu. Zabezpieczenie na poziomie prompta jest niewystarczające. Pewniejszy jest próg podobieństwa scoreThreshold w quadrant.QueryAsync: wyniki poniżej ustalonej wartości nie trafiają do modelu, a narzędzie zwraca wtedy wprost informację, że nic nie znaleziono. Wartość progu zależy od modelu embedding i trzeba ją dobrać na własnych danych. Liczby z ramki wyżej są poglądowe i dotyczą tylko tego zestawu ksiąg.
Jakość zależy od fragmentów
Podział po sekcjach działa, bo księgi są krótkie i uporządkowane. Zbyt duże fragmenty rozmywają wektor i wciągają do kontekstu niepotrzebny tekst, a zbyt małe tracą kontekst, bez którego nie da się odpowiedzieć. Wartość top-k zmienia kompromis między kompletnością odpowiedzi a liczbą tokenów. Oba parametry warto sprawdzać na realnych pytaniach, a nie ustawiać raz na podstawie intuicji.
Aktualność indeksu
Demo przebudowuje kolekcję przy każdym starcie, co wystarcza dla trzech plików. Przy większym zbiorze dokumentów potrzebne jest indeksowanie przyrostowe: ponowne liczenie wektorów tylko dla zmienionych plików i usuwanie fragmentów po usuniętych dokumentach. Inaczej agent odpowiada na podstawie nieaktualnej wersji.
Podsumowanie
Agent przed odpowiedzią przeszukuje bibliotekę w Qdrant narzędziem search_library. Embeddingi generuje lokalnie Ollama, bo Anthropic, na dzień dzisiejszy, nie udostępnia takiego modelu. Na tym samym pytaniu widać różnicę: bez biblioteki nowicjusz podaje zmyślony przedział, z biblioteką (RAG) odpowiada zgodnie z prawdą i mówi, z której księgi pochodzi odpowiedź. Pętlę wywołań narzędzia i wysyłanie jego definicji do modelu bierze na siebie framework. Reszta zostaje po stronie aplikacji: sposób dzielenia dokumentów, liczba zwracanych fragmentów i próg, poniżej którego wyszukiwanie uznaje, że nic nie pasuje.
Pełny kod: github.com/nowakdawid-blog/LibraryRagDemo.